
Bir kelimenin bağlamını kaçırmak, bir çeviride “pirinç kaseleri” üretmek ya da hukuki bir kararı eksik bilgiyle almak… Yapay zekanın bilgiyle ilişkimizde yarattığı asıl sorun her zaman yanlış cevap vermesi değil. Bazen daha önemli soru, bize hangi ihtimalleri göstermediği.
Bir yapay zeka uygulamasına bir soru sorduğunuzda çoğu zaman karşınıza tereddüt etmeyen, düzgün kurulmuş ve ikna edici bir cevap çıkıyor. Arama motorunda olduğu gibi onlarca bağlantı arasından seçim yapmak zorunda kalmıyorsunuz. Cevap hazır geliyor.
Tam da burada bilgiyle kurduğumuz ilişkinin biçimi değişiyor.
İngilizce “searching” yerine “asking” demek, yani aramak yerine sormak, yalnızca teknolojik bir kullanım alışkanlığı değişikliği değil. İtalyan filozof Luciano Floridi’ye göre mesele, bilgiye ulaşırken yaptığımız epistemik çalışmanın başka bir yere taşınması. Arama motoru kullanıcıya kaynaklar arasında seçim yapma zorunluluğu getirirken, üretken yapay zeka tek ve akıcı bir yanıt vererek bu seçimin bir bölümünü kullanıcının elinden alabiliyor.
Floridi’nin ifadesiyle üretken yapay zeka, şimdiye kadar geliştirdiğimiz en güçlü “proxy”, yani aracılardan biri. Ancak modelin ürettiği şey kendi başına bir tanıklık ya da ölçüm değil; istatistiksel olarak makul görünen bir devamlılık. Modelin anlattığı şeyle doğrudan epistemik bir ilişkisi bulunmuyor.
Sorun da tam burada başlıyor: Akıcı bir cevap, bilgi sahibi olduğumuz anlamına geliyor mu?
“Çok güldüm” nasıl pirinç kaselerine dönüştü?
Yapay zeka destekli çevirinin gündelik hayattaki karşılığı bazen oldukça basit bir yanlış anlaşılma.
Fransız yazar Marc Levy, yakın zamanda yaşadığı bir çeviri deneyimini anlatırken birine “çok güldüğünü” söylediğini, çevirinin ise bunu “pirinç kaseleri yedim” şeklinde aktardığını anlatıyor.
Tek başına bakıldığında bu örnek komik. Fakat mesele yalnızca komik bir çeviri hatası değil. Çünkü çeviri sistemleri çoğu zaman bize bir karşılık vermeyi tercih ediyor; oysa insan çevirmen, bir ifadenin bağlama tam olarak oturmadığını fark ettiğinde durabiliyor, açıklama isteyebiliyor ya da belirsizliği koruyabiliyor.
Floridi’nin dikkat çektiği risklerden biri de burada: Makine çevirisi dil bariyerlerini azaltabilirken, diller arasında birebir karşılığı bulunmayan anlamları “düzleştirebiliyor”. Özellikle kültürel bağlam, ironi ve çok anlamlılık söz konusu olduğunda akıcı bir cümle, doğru bir cümle olduğu izlenimi yaratabiliyor.
İspanyolca eğitmeni İbrahim Özkalemkaş’ın yaşadığı bir olay da bu farkı başka bir açıdan gösteriyor.
İspanya’da bir kafede bulunan Özkalemkaş’a garson “Cuéntame, ¿qué piensas?” diye soruyor. Özkalemkaş, Google Translate üzerinden “contar” fiilinin “saymak” anlamını görüyor ve ifadeyi bu anlam üzerinden yorumluyor. Oysa burada kullanılan fiil “anlatmak” anlamında.
Sonradan fark ettiği şey basit ama dil öğrenimi açısından önemli: Bir kelimenin sözlük karşılığını bilmek, o kelimenin cümlede ne yaptığını anlamaya yetmiyor.
Yapay zeka da benzer biçimde bize doğru bir parçayı verip bütünü kaçırabiliyor.
Asıl risk yanlış cevap mı?
İsmini paylaşmak istemeyen bir öğretmenin yaşadığı olay ise meselenin daha ciddi bir boyutunu ortaya koyuyor.
Birkaç yıl önce alacaklı olduğu bir icra dosyası için bir avukatla çalışan öğretmen, avukatından dosyanın ilerlediğine ilişkin bilgiler alıyordu. Avukatının, alacaklı olduğu kişinin üzerindeki taşınmazları satışa çıkardığını ve sonuç beklediğini söylediğini aktarıyor. Bu işlemler için kendisinden çeşitli evrak ve işlem bedelleri de talep ediliyordu.
Bir gün tesadüfen UYAP üzerinden dosyayı kontrol eden öğretmen, avukatının daha önce alacaklı kişinin bir arsasını ve otomobilini icra yoluyla satarak tahsilat gerçekleştirdiğini fark ettiğini söylüyor. Avukatına ulaşmaya çalışıyor ancak yanıt alamıyor.
Bunun üzerine UYAP ekran görüntülerini Gemini’ye yükleyerek durumu yorumlatıyor.
Yapay zeka, eldeki bilgilere dayanarak avukatın görevini ihlal etmiş olabileceğini söylüyor ve öğretmene avukatı azletmesi, ardından baroya başvurması yönünde tavsiyede bulunuyor.
Öğretmen de panikle notere giderek avukatını azlediyor.
Sonrasında görüştüğü başka avukatlardan ise dosyanın hukuki durumunun yapay zekanın sunduğu kadar tek yönlü olmadığı yönünde görüşler aldığını aktarıyor. Azlin ardından eski avukatından da kendi alacağına ilişkin bir talep geliyor.
Öğretmenin bugün geriye dönüp baktığında asıl itirazı yalnızca yapay zekanın verdiği cevaba değil. Ona göre sorun, yapay zekanın kendisine başka ihtimalleri göstermemesi.
Çünkü bir hukuk uzmanının önünde “avukat görevini ihlal etmiş olabilir” ihtimali kadar, “önce başka hangi belgeleri kontrol etmeliyim?”, “azletmeden önce hangi hukuki yolu izlemeliyim?”, “avukatın tahsil ettiği bedel ile kendi alacağı arasındaki ilişki nedir?” gibi sorular da bulunabilir.
Yapay zeka bu soruların tamamını gündeme getirmediğinde, kullanıcı kendisine sunulan ilk açıklamayı nihai hukuki değerlendirme gibi algılayabilir.
Burada kritik mesele artık “Yapay zeka doğru mu söyledi, yanlış mı?” sorusundan daha geniş:
Yapay zeka, kullanıcının karar verebilmesi için gerekli bütün soruları görünür kıldı mı?
Bilmediğimiz şey, yanlış bildiğimiz şeyden daha önemli olabilir
Tevfik Uyar, yapay zeka ile bilgi edinme sürecini üç aşamada ele alıyor: Yapay zekadan bilgi almak; o bilginin nasıl üretildiğini ve ne anlama geldiğini anlamak; ardından doğruluğunu kontrol etmek.
İlk aşamada kalındığında, yapay zekanın kullanıcı adına düşünme riskinin ortaya çıktığını söylüyor.
Bu özellikle özet ve çeviri gibi işlemlerde önemli. Çünkü kullanıcı yalnızca yanlış bilgiyi değil, kendisine aktarılmamış bilgiyi de göremiyor.
Bir metin özetlendiğinde hangi ayrıntının çıkarıldığını bilmiyorsanız, eksikliği fark etmeniz mümkün olmayabilir. Bir yabancı dildeki ifade akıcı bir Türkçe cümleye dönüştüğünde, orijinal cümlenin taşıdığı belirsizliğin kaybolduğunu fark etmeyebilirsiniz.
Uyar’ın dikkat çektiği nokta tam da bu: Yapay zekanın en önemli riski yalnızca “halüsinasyon”, yani gerçekte olmayan bir bilgiyi üretmesi olmayabilir. Kullanıcının, neyin eksik bırakıldığını bilmemesi de başlı başına bir sorun.
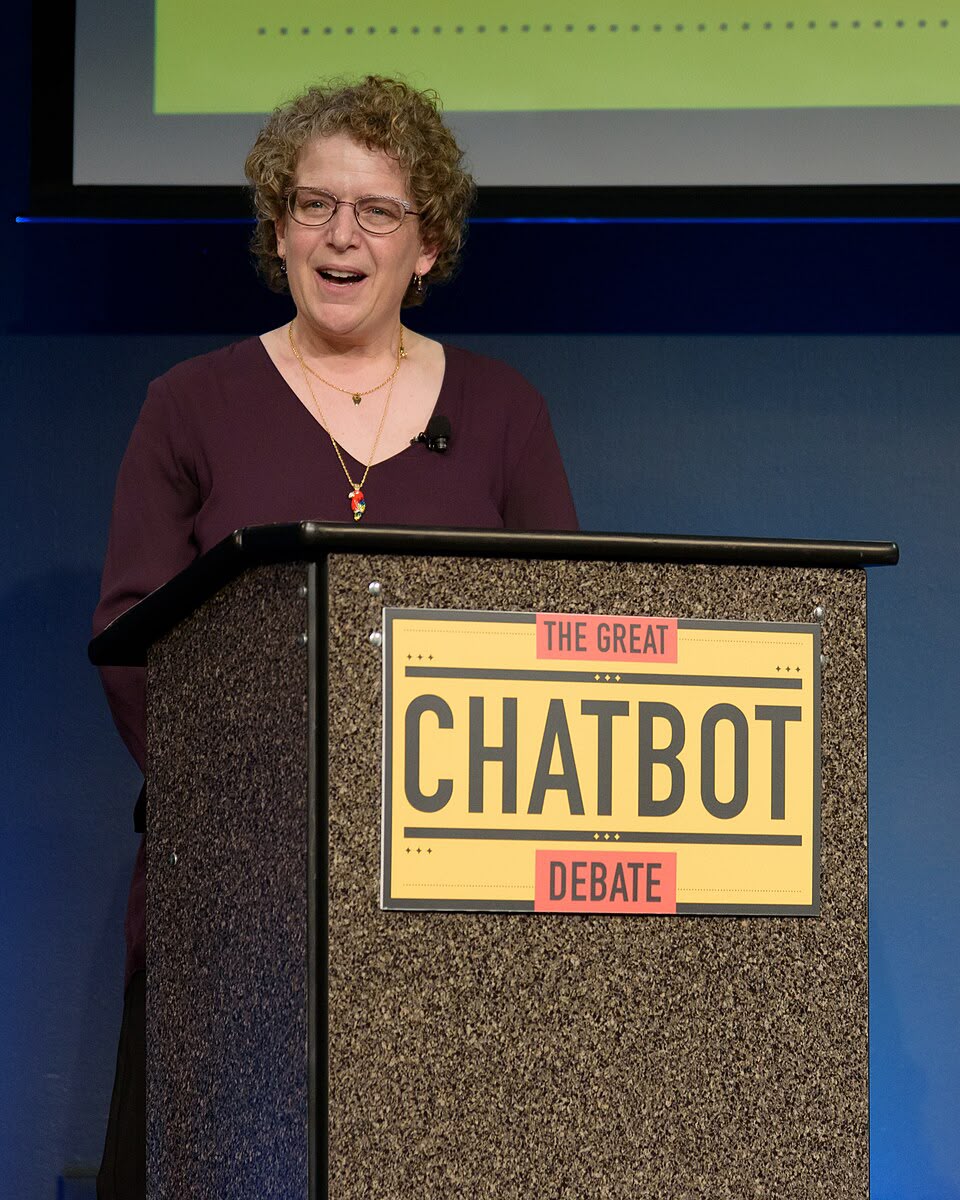
Emily M. Bender ise daha temel bir noktaya dikkat çekiyor: Akıcı dil, doğruluk veya anlamlılıkla aynı şey değil. İnsanlar düzgün ve kendinden emin bir dille karşılaştıklarında, o metnin arkasında da bir insanın sahip olduğu bilgi ve niyetin bulunduğunu varsaymaya yatkın.
Oysa üretken yapay zeka tarafından oluşturulan metnin arkasında aynı türden bir tanıklık bulunmuyor.
Kaynak mı, tanık mı?
Floridi bu ayrımı özellikle önemli buluyor: Yapay zeka bir kaynağa yönlendirebilir; ancak kendisi tanık değildir.
Bir belgeyi gösterebiliriz. Bir hesaplamaya yönlendirebiliriz. Bir araştırmanın kaynağını bulabiliriz. Fakat bunların doğruluğuna ilişkin sorumluluk hala o belgeye, araştırmaya, ölçüme veya onu üreten kişiye aittir.
Bu ayrım gazetecilik açısından daha da kritik.
Tevfik Uyar’a göre gazeteci için yapay zeka “kaynak” değil, kaynağa ulaşmaya yardımcı olan bir araç olabilir. “Yapay zekaya sordum, böyle söyledi” gazetecilik açısından yeterli bir dayanak değil. Birincil kaynağa ulaşmak, bilgiyi doğrulamak ve haberde kullanılan bilginin sorumluluğunu üstlenmek hala gazetecinin işi.
Floridi de gazetecilikte yapay zekanın araştırma, düzenleme veya çeviri süreçlerinde kullanılabileceğini; ancak yayımlanan metnin sorumluluğunun imza sahibinde kaldığını vurguluyor.
Bu nedenle mesele yalnızca gazetecinin yapay zeka kullanıp kullanmaması değil.
Bir gazeteci, bir akademisyen, bir öğrenci ya da sıradan bir kullanıcı bir bilgiyi yapay zekadan aldığında, o bilginin sorumluluğunu kimin üstlendiğini biliyor mu?
“İkinci görüş” neden yeterli değil?
İlk bakışta çözüm basit görünebilir: Emin değilsek başka bir yapay zekaya sorarız.
Fakat ikinci bir yapay zekanın aynı soruya benzer bir cevap vermesi, cevabın doğru olduğunu kanıtlamıyor.
Çünkü iki sistem de aynı türden bir aracılık mekanizmasının içinde çalışıyor olabilir. İkinci modelin birincisini doğrulaması, bizi mutlaka birincil kaynağa götürmüyor.
Uyar bu nedenle yapay zeka cevabının ardından kaynağa gitmeyi; Floridi ise “İkinci bir model bana da aynı şeyi söyledi” yaklaşımının gerçek bir doğrulamanın yerine geçmemesi gerektiğini savunuyor.
Bender’ın önerdiği soru ise daha temel: “Okuduğum metnin arkasında kim duruyor ve o kişinin kullandığı kaynakların gerçekten kaynak olduğunu nasıl biliyorum?”
Bilginin yeni maliyeti: Doğrulama
Belki de yapay zeka çağında değişen şey bilgiye ulaşmanın maliyeti değil, bilgiyi doğrulamanın maliyeti.
Eskiden bir arama motoruna aynı soruyu yazdığımızda karşımıza çıkan sonuçlar arasında seçim yapmak zorundaydık. Birden fazla kaynağa bakmak, tarihleri karşılaştırmak, bir haberin hangi belgeye dayandığını araştırmak zaman alıyordu.
Şimdi tek bir cümleyle bütün bu sürecin sonunda ortaya çıkmış gibi görünen bir cevap alabiliyoruz.
Bu büyük bir kolaylık.
Ama kolaylık ile güvenilirlik aynı şey değil.
Hatta yapay zekanın en ikna edici olduğu an, en fazla dikkat edilmesi gereken an olabilir: Cevap son derece akıcıdır, soruya doğrudan yanıt verir ve kullanıcı zaten inanmak istediği bir sonuca yakınsa, şüphe etmek için gereken zihinsel “sürtünme” ortadan kalkar.
Floridi bunu eleştirel düşünmenin kendisi açısından önemli buluyor. Ona göre eleştirel düşünme yalnızca sahip olunan bir özellik değil; çelişkili kaynakları karşılaştırırken, bir alıntının doğru kullanılıp kullanılmadığını kontrol ederken ve hangi kaynağa güvenileceğine karar verirken kullanılan bir beceri.
Mesele yapay zekayı kullanıp kullanmamak değil.
Hangi düşünme işini ona bıraktığımız.
Yapay zekaya güvenmek yerine onu nasıl kullanacağız?
Yapay zekanın bilgi aracısı olarak hayatımıza daha fazla girmesiyle birlikte “AI okuryazarlığı” da yalnızca iyi prompt yazabilmek anlamına gelmiyor.
Floridi’ye göre burada ihtiyaç duyulan şey epistemolojik bir AI okuryazarlığı: Kullanıcı, karşısındaki cevabın ne olduğunu bilmeli. Bunun bir ölçüm, tanıklık veya doğrudan gözlem değil; çoğu durumda makul bir metin üretimi olduğunu anlamalı.
Uyar da benzer biçimde yapay zekanın bir “asistan” olarak görülmesi gerektiğini, otoriteye dönüştürülmemesi gerektiğini söylüyor.
Belki bu nedenle yapay zekaya soru sormadan önce sorulması gereken soru, yalnızca “Doğru cevap ne?” olmamalı.
Şunları da sormak gerekiyor:
Bu cevap hangi kaynağa dayanıyor?
Bunun yanlış olduğunu nasıl anlayabilirim?
Burada hangi bilgi eksik olabilir?
Başka hangi ihtimaller var?
Bu bilgiye dayanarak bir karar vereceksem, önce kiminle veya hangi birincil kaynakla kontrol etmeliyim?
Yapay zeka bize cevap vermeyi kolaylaştırabilir.
Ama cevap vermekle karar vermek aynı şey değil.
Ve belki de yapay zeka çağının en önemli bilgi becerisi, bir makinenin verdiği cevabı ne kadar hızlı kabul ettiğimiz değil, o cevabın bizi hangi soruları sormaktan alıkoyduğunu fark edebilmek.
Yapay zekâ yanıtı neden tek başına kaynak sayılmaz?
Yanıt, bir belgeyi veya araştırmayı bulmaya yardım edebilir. İddianın dayanağı olan özgün kayıt yine ayrıca incelenmelidir.
İki yapay zekâ aynı cevabı verirse bilgi doğrulanmış olur mu?
Hayır. Benzer yanıtlar, modellerin ortak bir hatayı veya eksik varsayımı tekrarlamadığını göstermez.
Bir yapay zekâ yanıtını kullanmadan önce ne sorulmalı?
“Bu hangi kaynağa dayanıyor?”, “Hangi bilgi eksik olabilir?” ve “Karar vermeden önce kiminle ya da hangi belgeyle kontrol etmeliyim?”
Yapay zekanın maddi coğrafyası: Dijital kapitalizm ve ekolojik kriz

